01
IFU/WBU ready 死锁
取指端与写回端的 ready 信号相互依赖,导致流水线停滞。重新划分握手逻辑,由各级缓存状态和下游接收能力决定是否推进,消除 ready 信号闭环。
数字集成电路 · RTL · SoC
独立设计与实现 RV32E 处理器,已完成五级流水线与 2-bit 分支预测。项目还包括验证环境、SoC 集成、指令缓存,以及综合和静态时序分析实践。
先实现 NEMU 指令级模拟器,再设计 RV32E 处理器 RTL。NEMU 执行程序并提供寄存器与内存状态,作为差分测试的参考模型;RTL 覆盖取指、译码、执行、访存和写回。
处理器从多周期版本起步,经过两级流水探索,逐步演进为当前实现。接入 ysyxSoC 后,结合 NEMU 差分测试与 Verilator 波形,调试启动程序、存储器、外设访问及控制流。
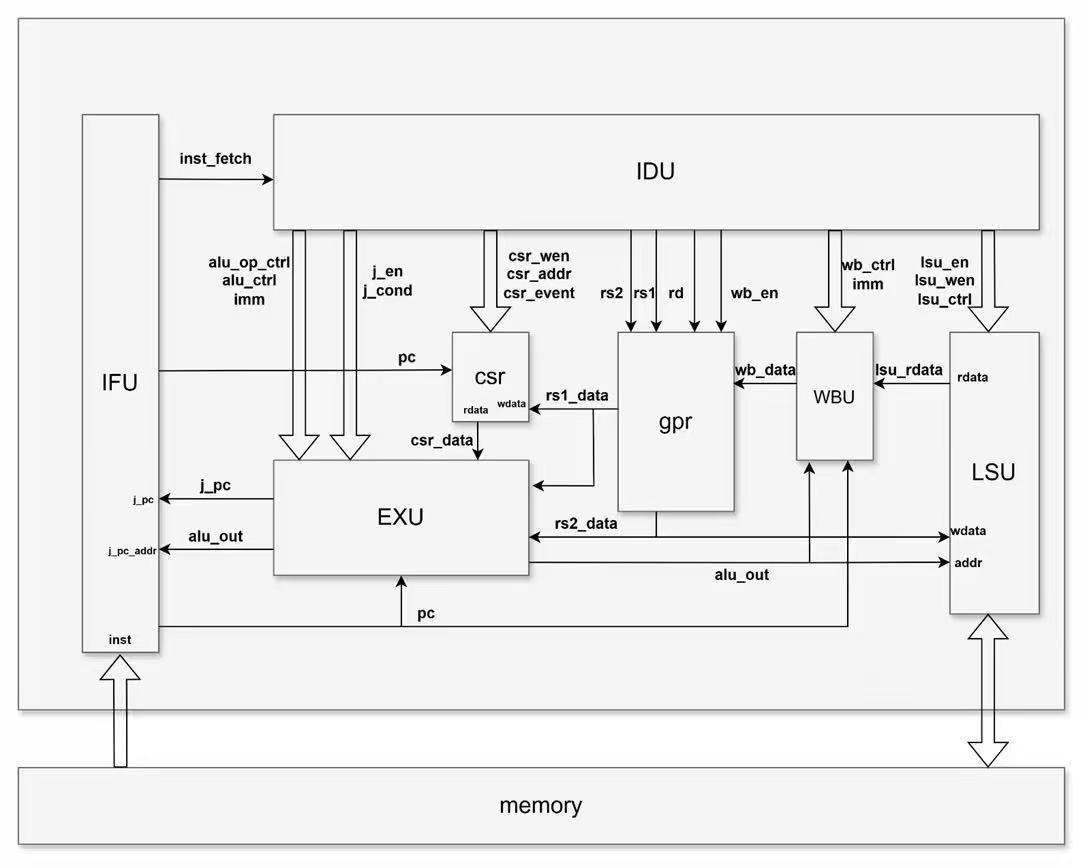
当前版本采用取指、译码、执行、访存和写回五级流水线,并已实现 2-bit 分支预测。
控制逻辑重点处理停顿、跳转和可变延迟访存。分别保存取指请求的 PC 与已接收指令的 PC,并跟踪请求和响应,避免指令与地址错配。
RV32E 基础整数运算、逻辑、移位、分支和跳转指令由译码逻辑生成控制信号,再在 EXU 中完成运算与条件判断。加载与存储指令通过 LSU 将访问请求转为总线事务;写回阶段根据指令类别选择算术结果、加载数据或 PC 相关结果。
控制与状态寄存器(CSR)访问、ECALL 环境调用、MRET 异常返回和异常处理共用控制流管理逻辑,统一处理寄存器读写、异常入口与返回地址。FENCE.I 用于同步指令流;本实现通过使指令缓存(ICache)失效,保证修改代码后能取到更新的指令。
运行指令集测试、riscv-tests 和自定义程序时,我逐条比对 RTL 与 NEMU 的寄存器和执行状态,检查算术、控制流、访存和异常处理。遇到不一致的指令,再用 GTKWave 查看 Verilator 生成的 FST 波形,定位握手、总线响应或寄存器更新问题。
已在 RTL CPU 上运行 RT-Thread,验证启动、中断、串口、内存布局与外设访问。
处理器通过 AXI4-Lite 总线互连接入片上系统,访问 SRAM、核心本地中断控制器(CLINT)和串口(UART)等模块。互连负责仲裁取指与访存请求、解析地址并返回响应;启动程序和外设驱动使用一致的地址映射。
指令侧加入直接映射缓存,将地址划分为标记、索引和偏移。命中时直接返回指令;未命中时,回填状态机发起访存并更新缓存行。FENCE.I 会触发缓存失效处理。
使用 Yosys 进行逻辑综合、iSTA 进行静态时序分析,并在 Innovus 中探索物理实现。根据综合报告检查面积构成,根据时序报告定位关键路径;其中针对指令缓存的标记比较器做过实现调整,以改善取指路径时序。
完成多周期控制设计,通过差分测试和波形检查验证功能。
接入 AXI4-Lite、外设与指令缓存,处理总线和控制流问题。
完成综合与静态时序分析,并探索 Innovus 物理实现,检查面积和关键路径。
01
取指端与写回端的 ready 信号相互依赖,导致流水线停滞。重新划分握手逻辑,由各级缓存状态和下游接收能力决定是否推进,消除 ready 信号闭环。
02
取指请求发出后,当前 PC 可能先发生变化。请求发出时保存 PC,响应到达时再将对应 PC 与指令一同写入缓冲,避免返回指令与地址错配。
03
分支、跳转或异常发生时,仍可能有尚未返回的取指请求。通过记录请求状态和响应归属,丢弃不再属于当前执行路径的指令。
04
指令缓存回填与访存请求共用 AXI 通道。仲裁器记录请求来源,并将返回数据交给对应模块,避免可变延迟下的响应错配。
下表记录早期多周期版本运行 RT-Thread 时的执行周期、指令数与 IPC。
早期多周期版本 · RT-Thread 运行记录
| 执行周期 | 29,825,900 |
|---|---|
| 已提交指令数 | 590,845 |
| 平均每周期指令数(IPC) | 0.0198 |
后续探索方向包括数据缓存(DCache)、片上网络(NoC)与多核扩展。新增模块将接入现有片上系统与差分测试流程。